Das Wichtigste in Kürze
- Die Toxizitätsvorhersage deckt 42 ADMET- und Toxizitäts-Endpunkte in einer einzigen Suite ab: von Tox21 über CYP450 bis Ökotoxikologie.
- Mittlerer Klassifikations-AUC auf dem harten Scaffold-Holdout: 0,860; 19 Endpunkte erreichen AUC ≥ 0,85.
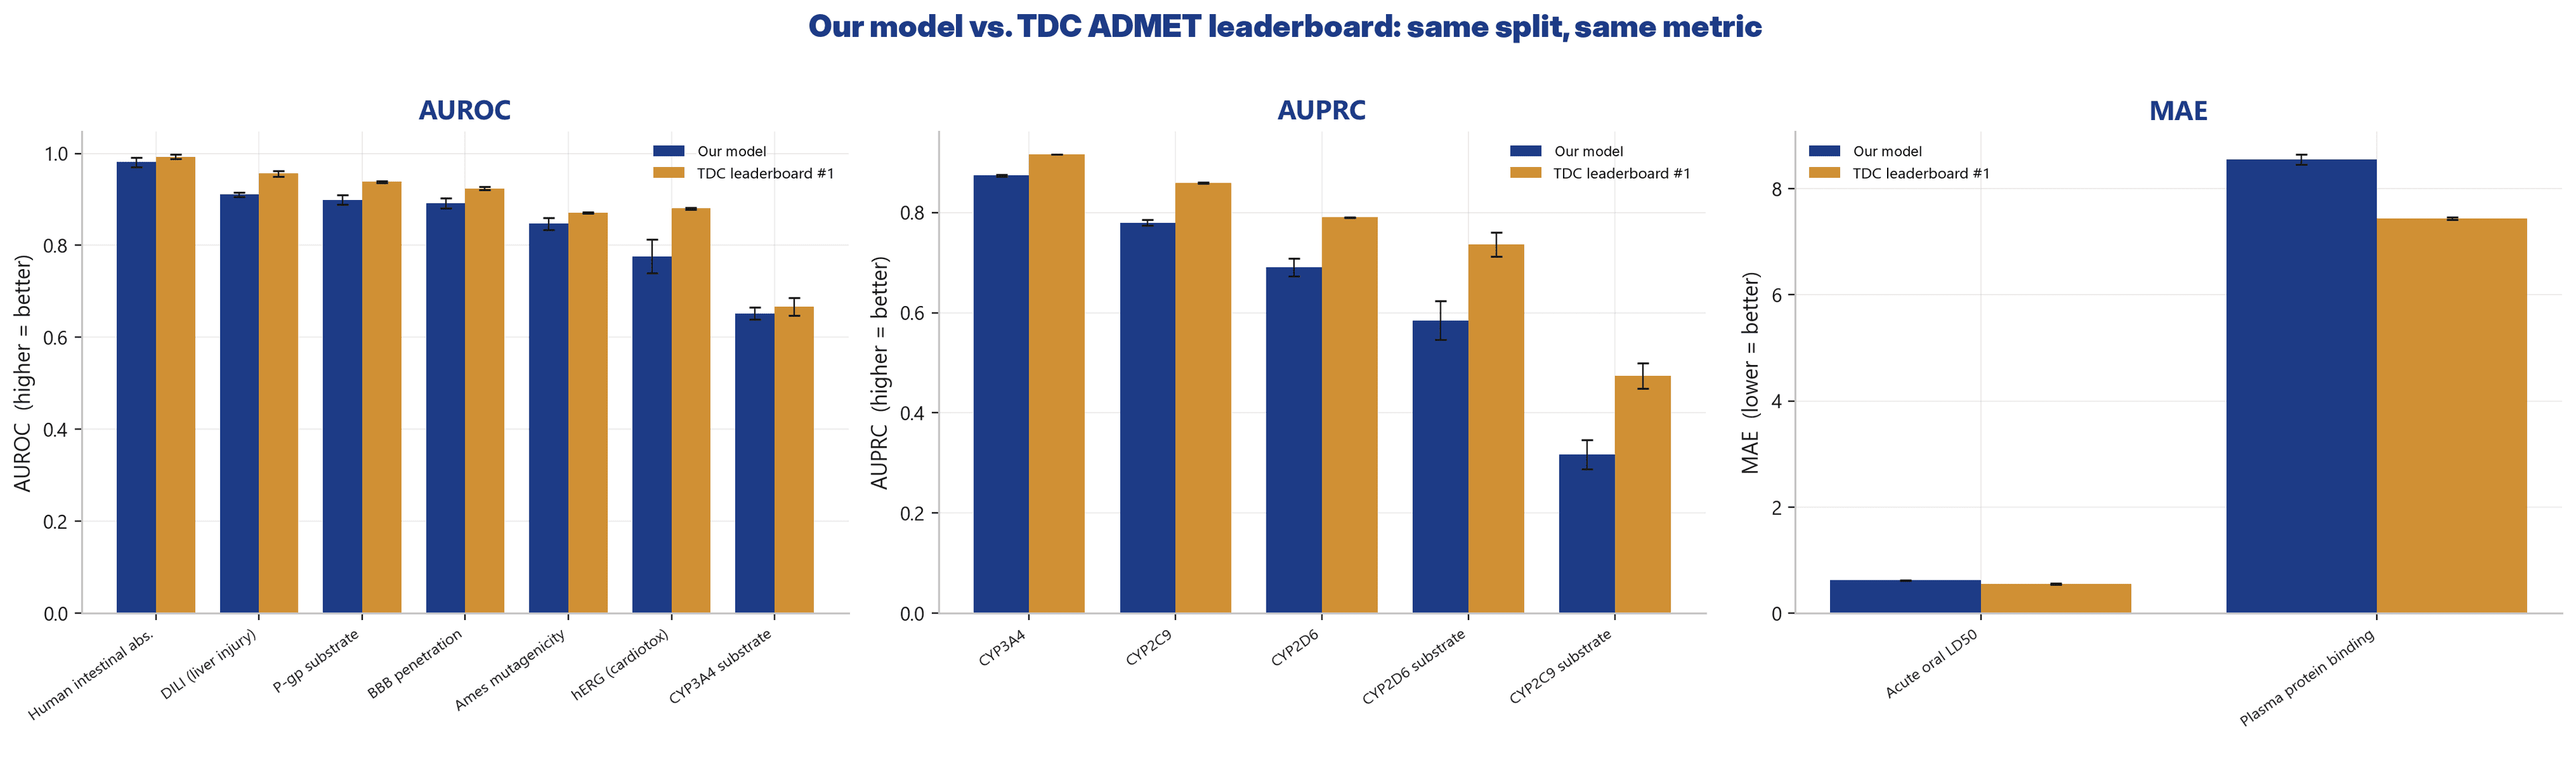
- Wir haben einen echten Same-Split-Same-Metric-Vergleich gegen das TDC-ADMET-Leaderboard durchgeführt: neu trainiert auf TDCs offiziellem Split, bewertet mit TDCs eigenem Evaluator.
- Das Ergebnis ehrlich: die Toxizitätsvorhersage liegt auf den AUROC-Endpunkten im Schnitt wenige Punkte unter dem jeweils besten, auf einen Datensatz spezialisierten Modell, und das mit einem Standardmodell über alle Endpunkte.
- Wir benennen die Schwachstellen offen (Substrat-Endpunkte, PPBR) statt sie zu verstecken.
Die Frage hinter dem Benchmark
Toxizität und ADMET-Eigenschaften entscheiden früh über Erfolg oder Scheitern eines Wirkstoffs. Mutagenität, hERG-Kardiotoxizität, Leberschädigung, CYP450-Wechselwirkungen: Wer diese Risiken erst spät erkennt, verbrennt Jahre und Budget. Die naheliegende Hoffnung: Kann ein Modell diese Eigenschaften vorhersagen, bevor man ins Labor geht?
Die ehrliche Antwort lautet: teilweise, je nach Endpunkt sehr gut und in manchen Fällen noch nicht gut genug. Genau diese differenzierte Antwort liefern wir hier, mit offengelegten Zahlen statt eines Marketing-Versprechens.
Was die Toxizitätsvorhersage abdeckt
Der erste Wert der Toxizitätsvorhersage liegt nicht in einer einzelnen Spitzenzahl, sondern in der Breite: 42 ADMET- und Toxizitäts-Endpunkte in einer Suite mit einem einzigen, einheitlichen Zugang.
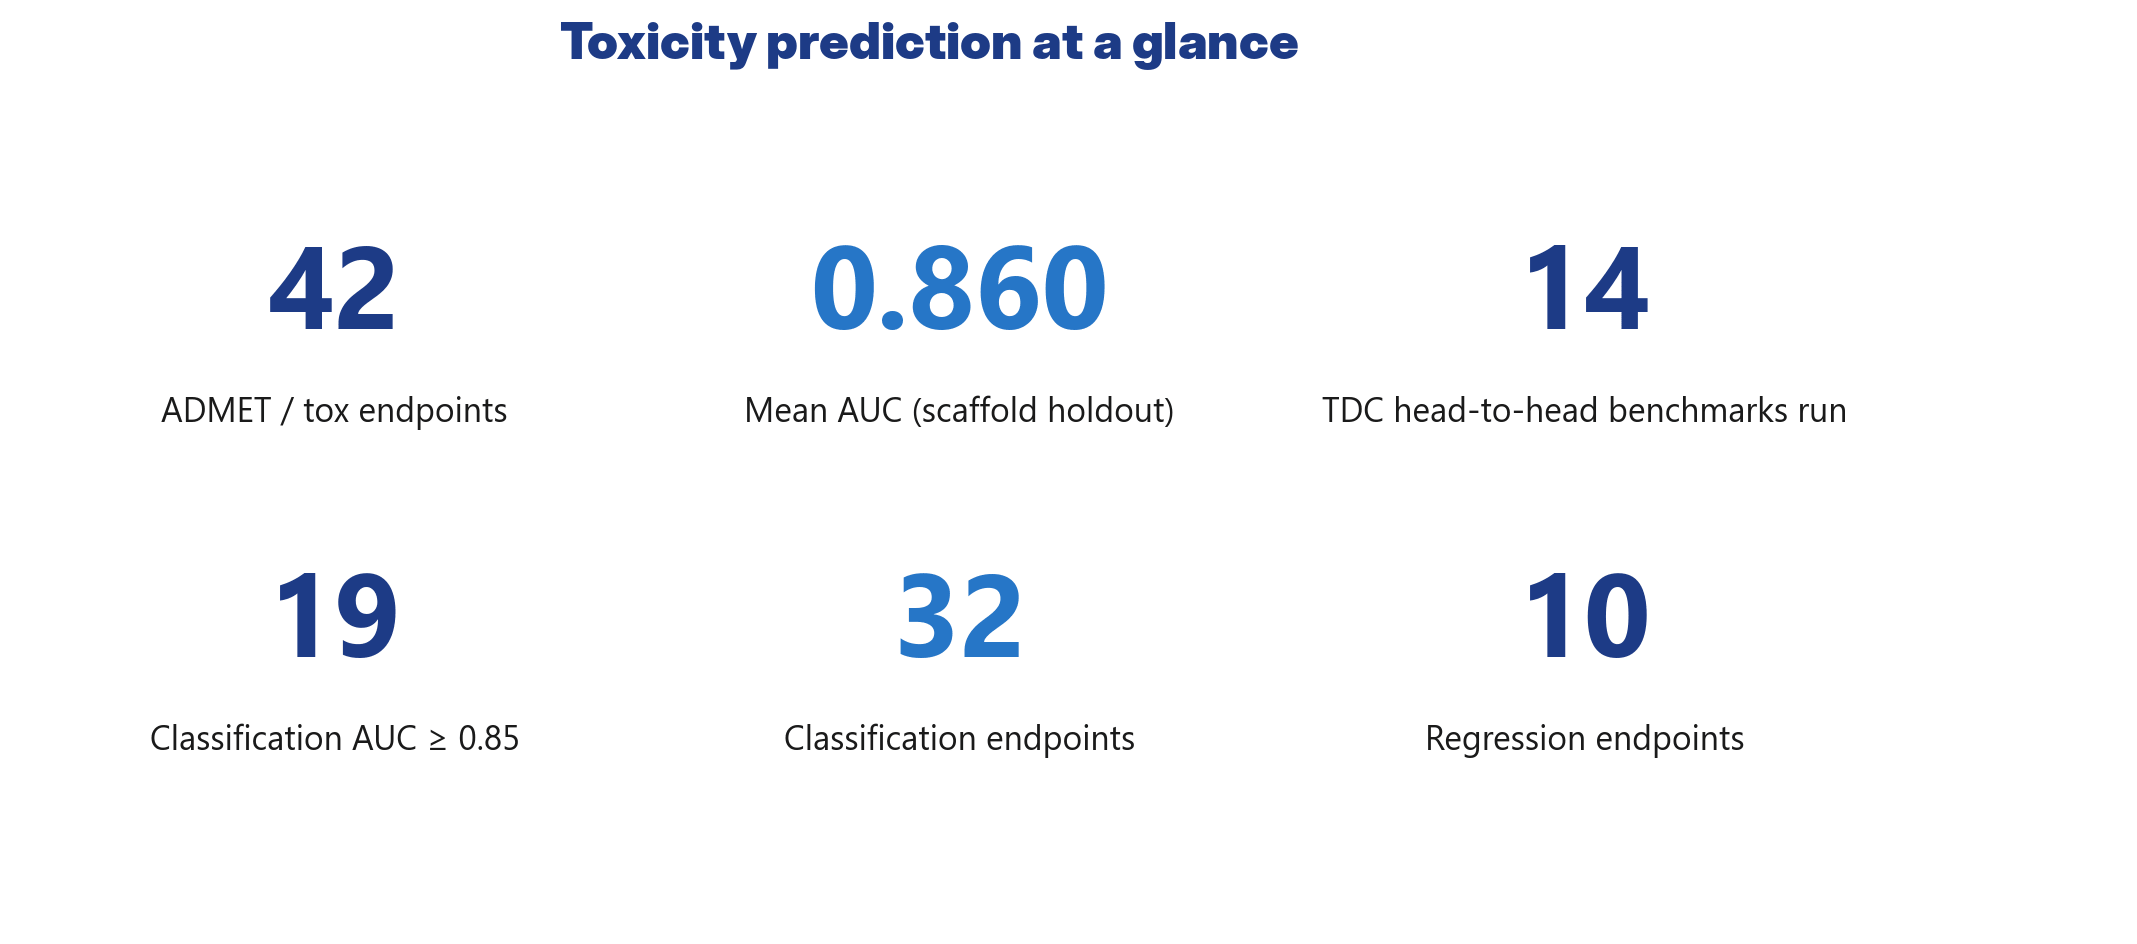
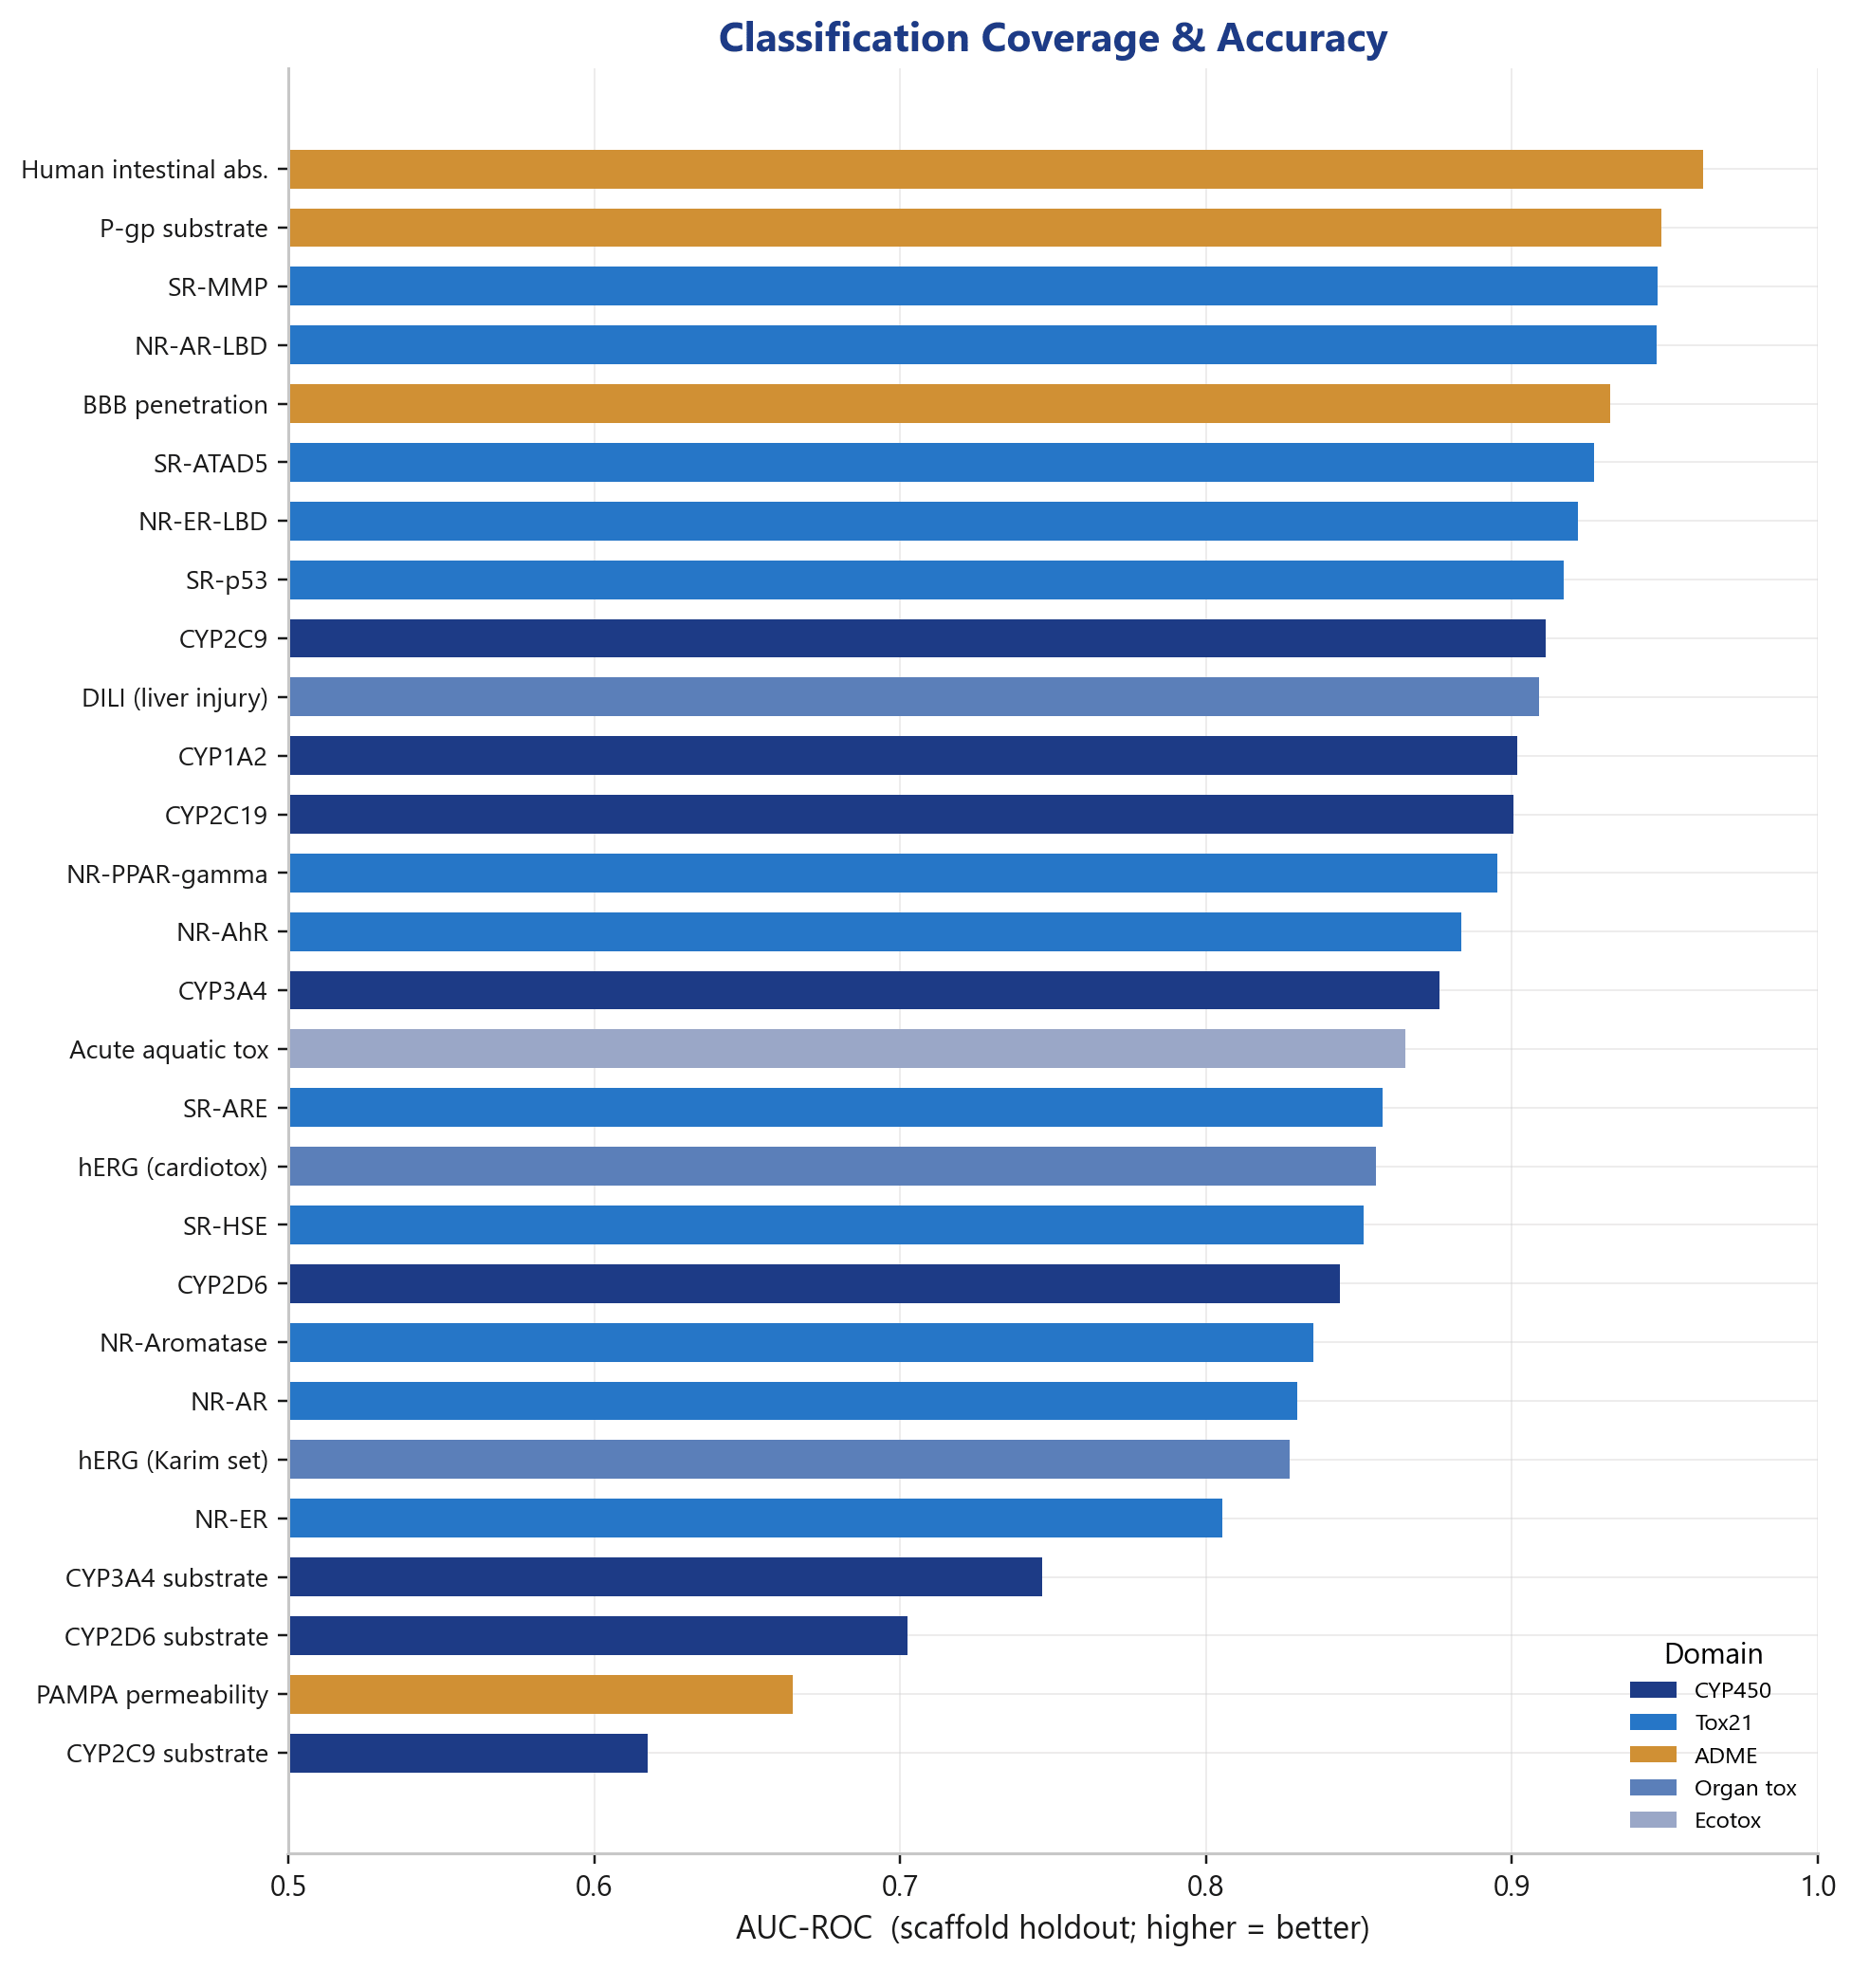
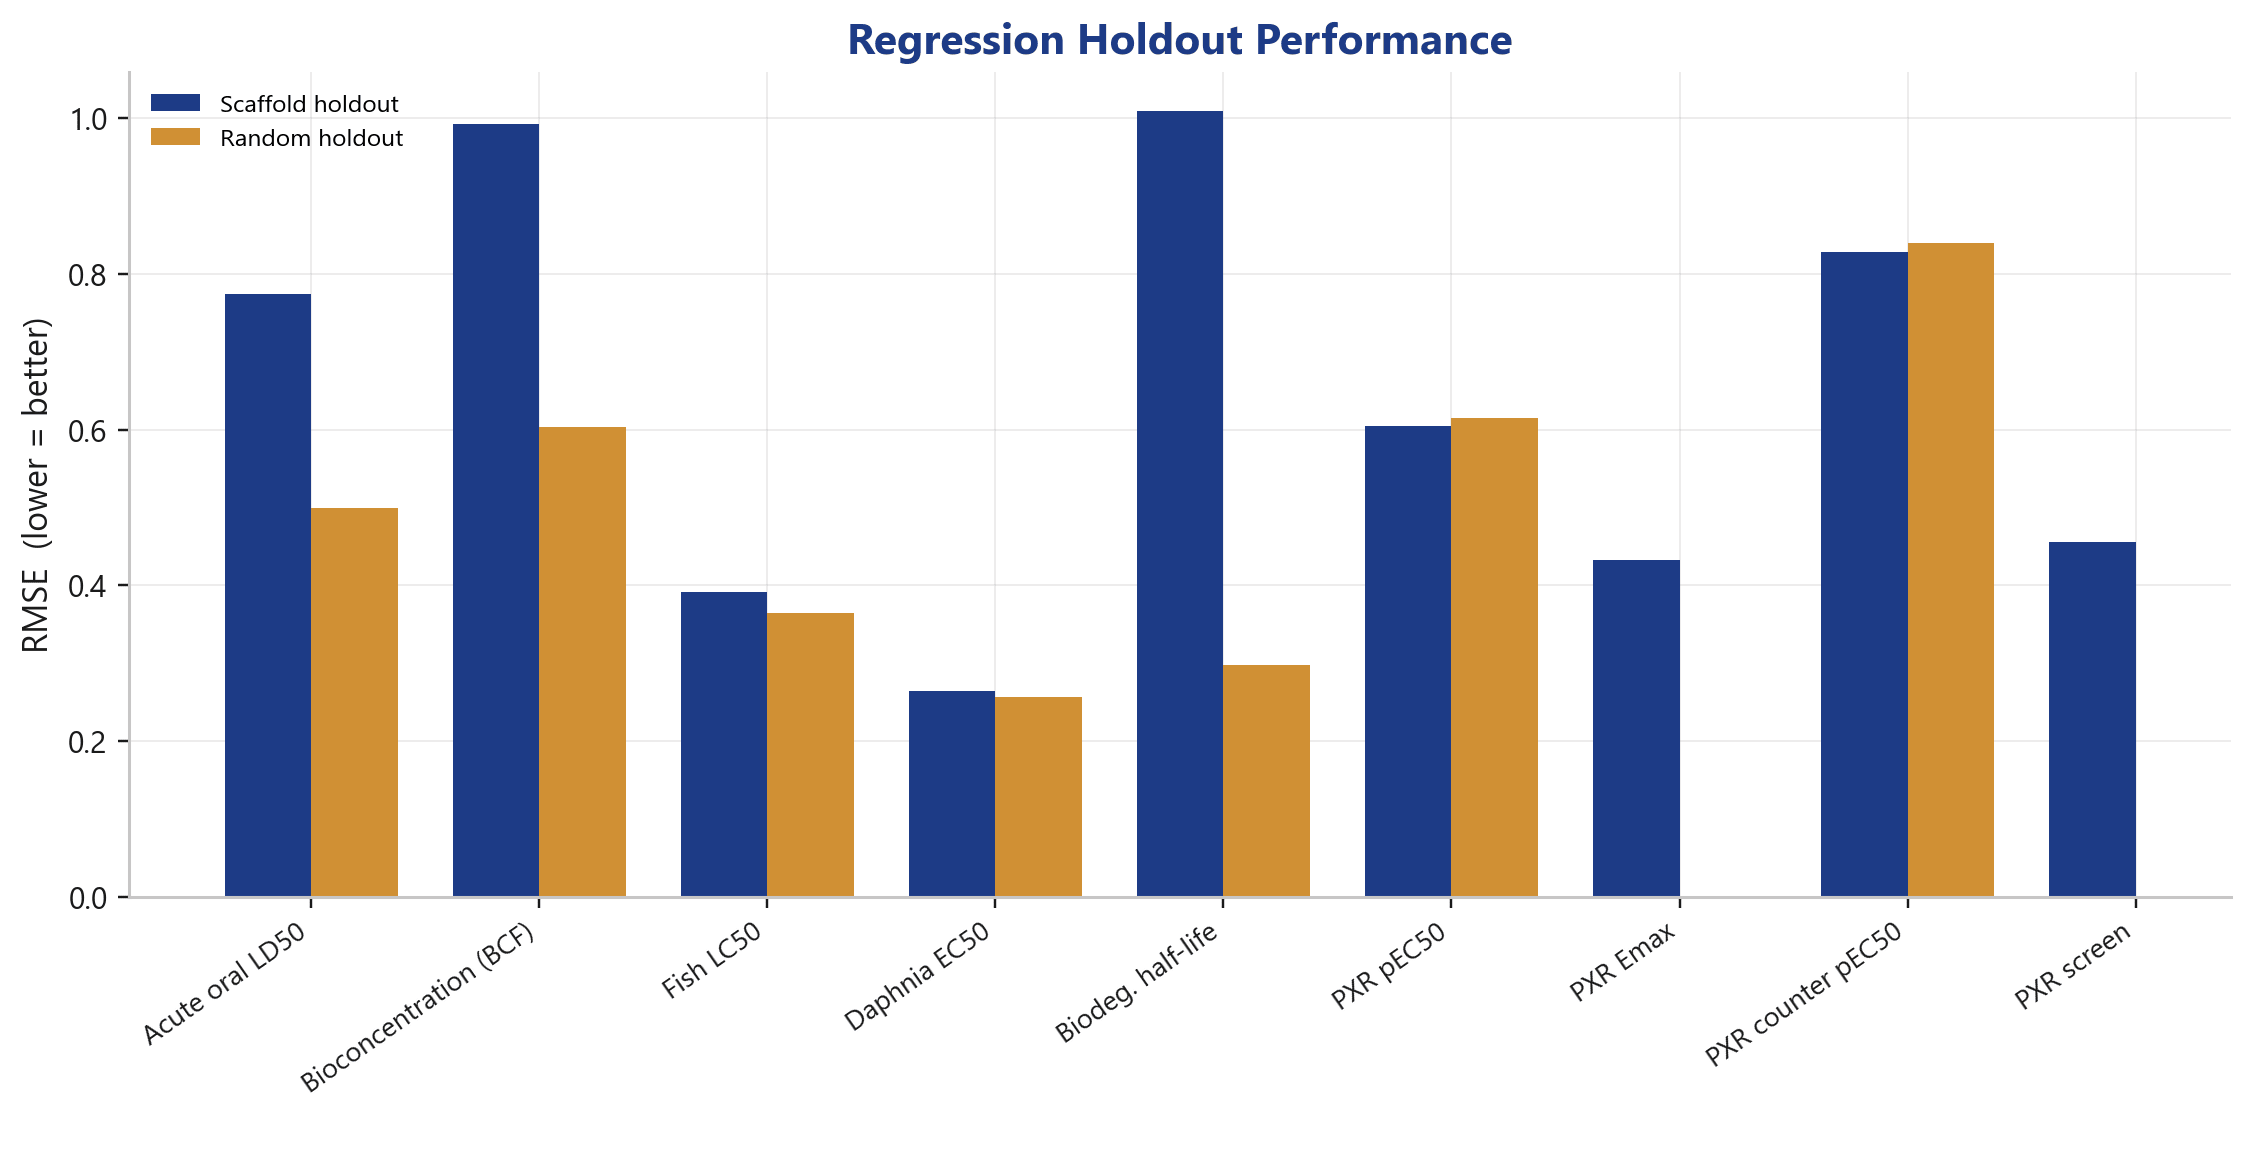
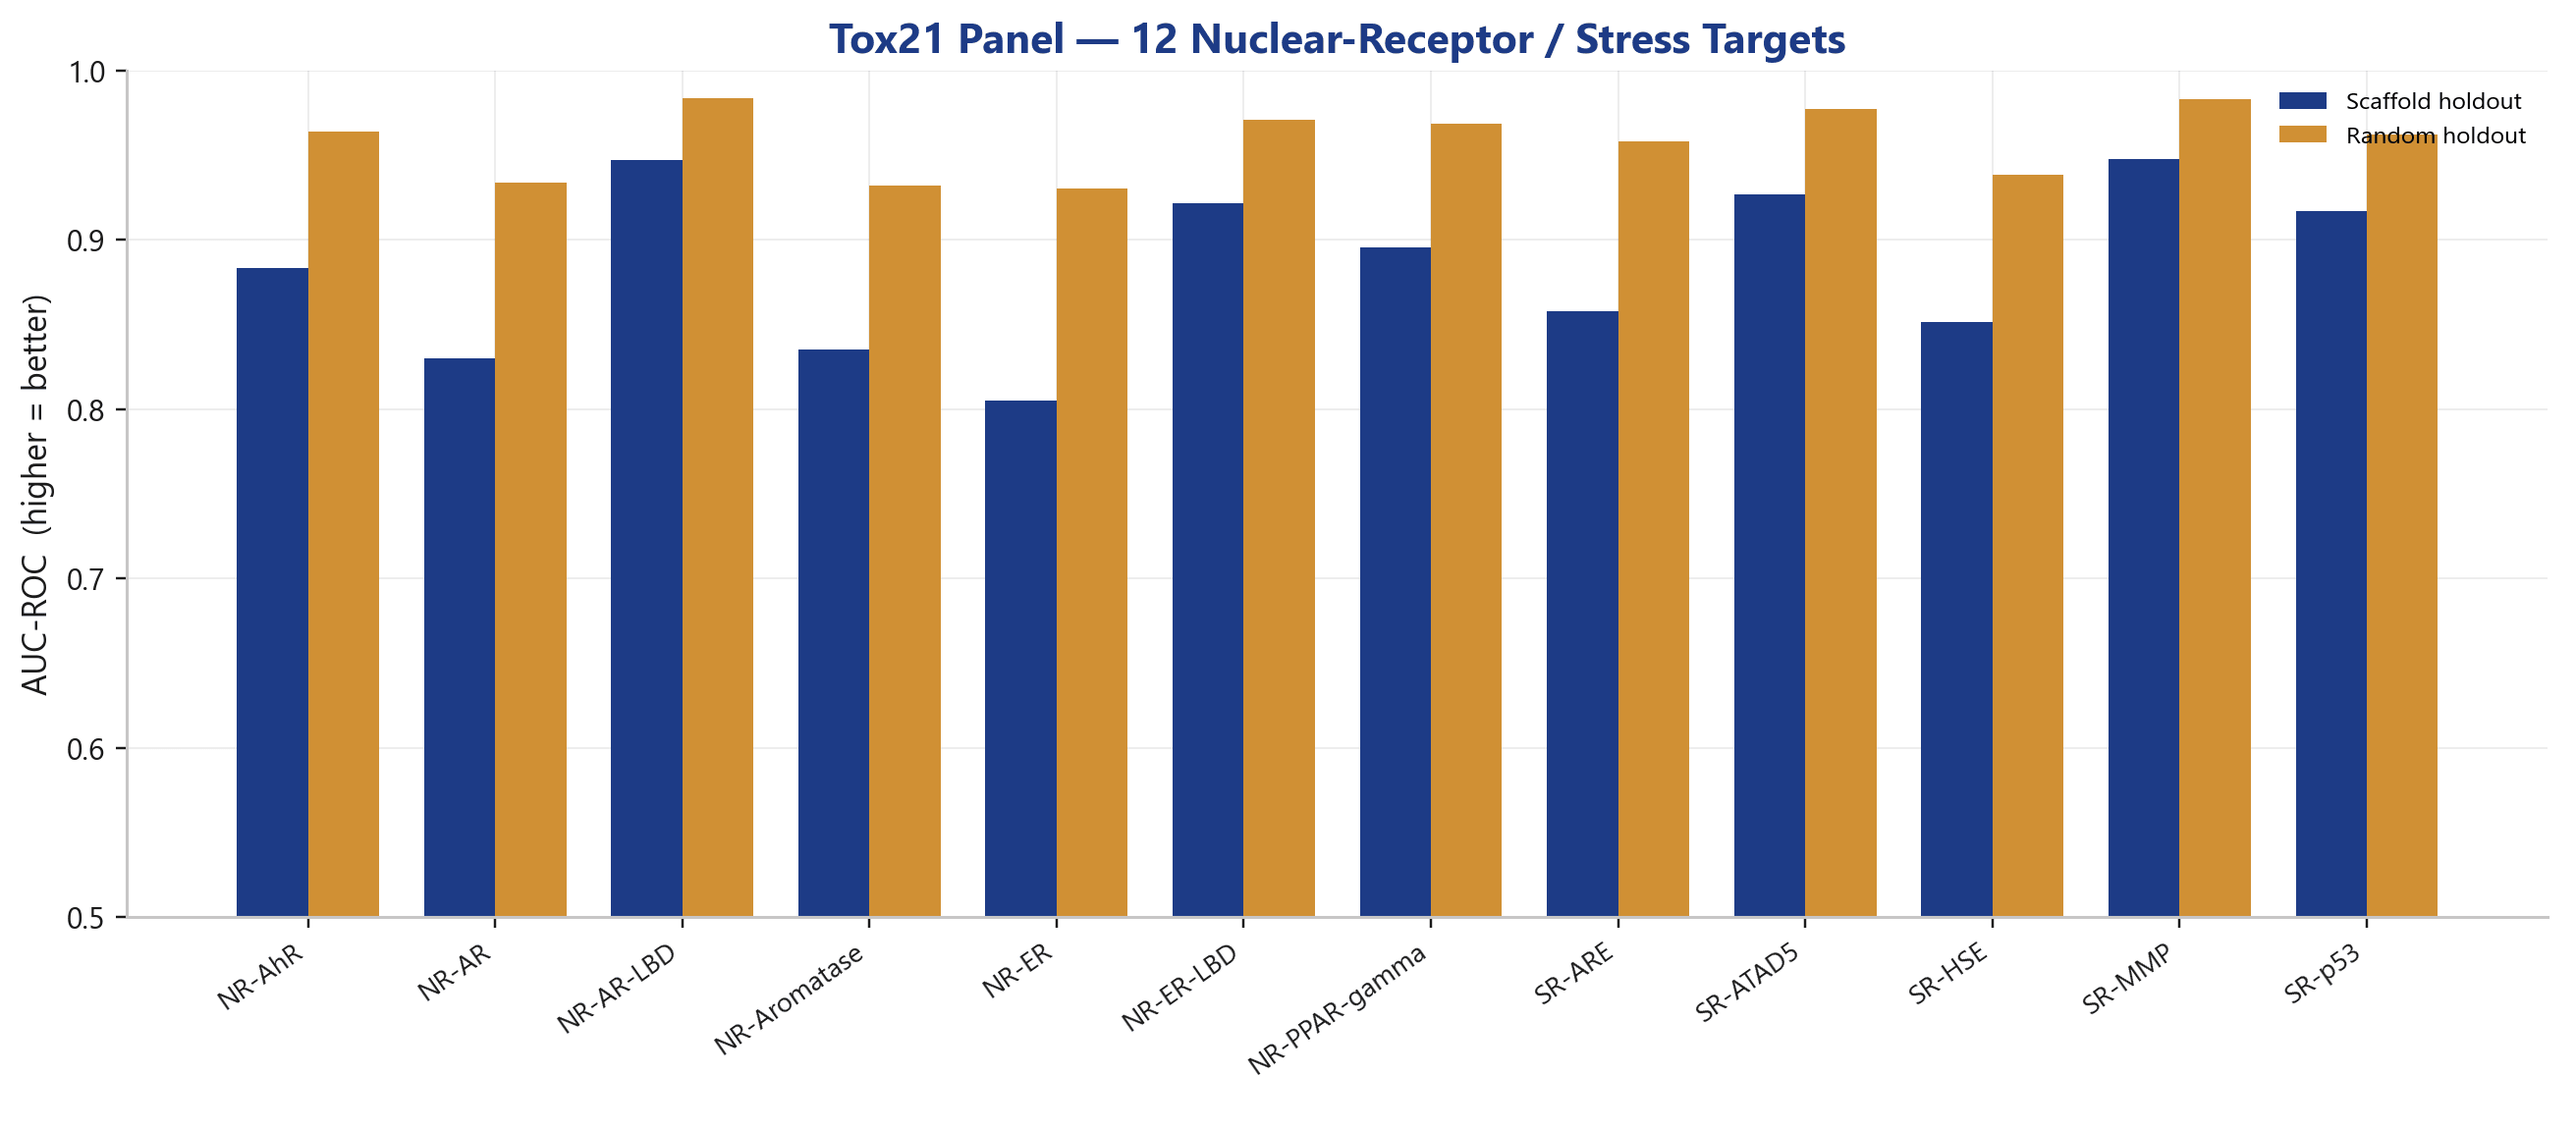
Konkret sind das 32 Klassifikations- und 10 Regressions-Endpunkte, gruppiert in Domänen-Familien: das vollständige Tox21-Panel (12 Kernrezeptor- und Stressantwort-Ziele), das CYP450-Panel (fünf Inhibitions-Isoformen plus Substrat-Vorhersage), klassische ADME-Endpunkte (Darmabsorption, BBB, P-gp, PAMPA), Organtoxizität (DILI, hERG) und Ökotoxikologie. Der mittlere Klassifikations-AUC auf dem Scaffold-Holdout liegt bei 0,860, und 19 Endpunkte erreichen einen AUC von 0,85 oder höher.
Für ein Sicherheitsprofil ist diese Breite der eigentliche Hebel: Eine einzige Anbindung deckt das ab, wofür man sonst ein gutes Dutzend einzelner, separat gepflegter Modelle bräuchte.
Der ehrliche Teil: Scaffold-Holdout, nicht Random-Split
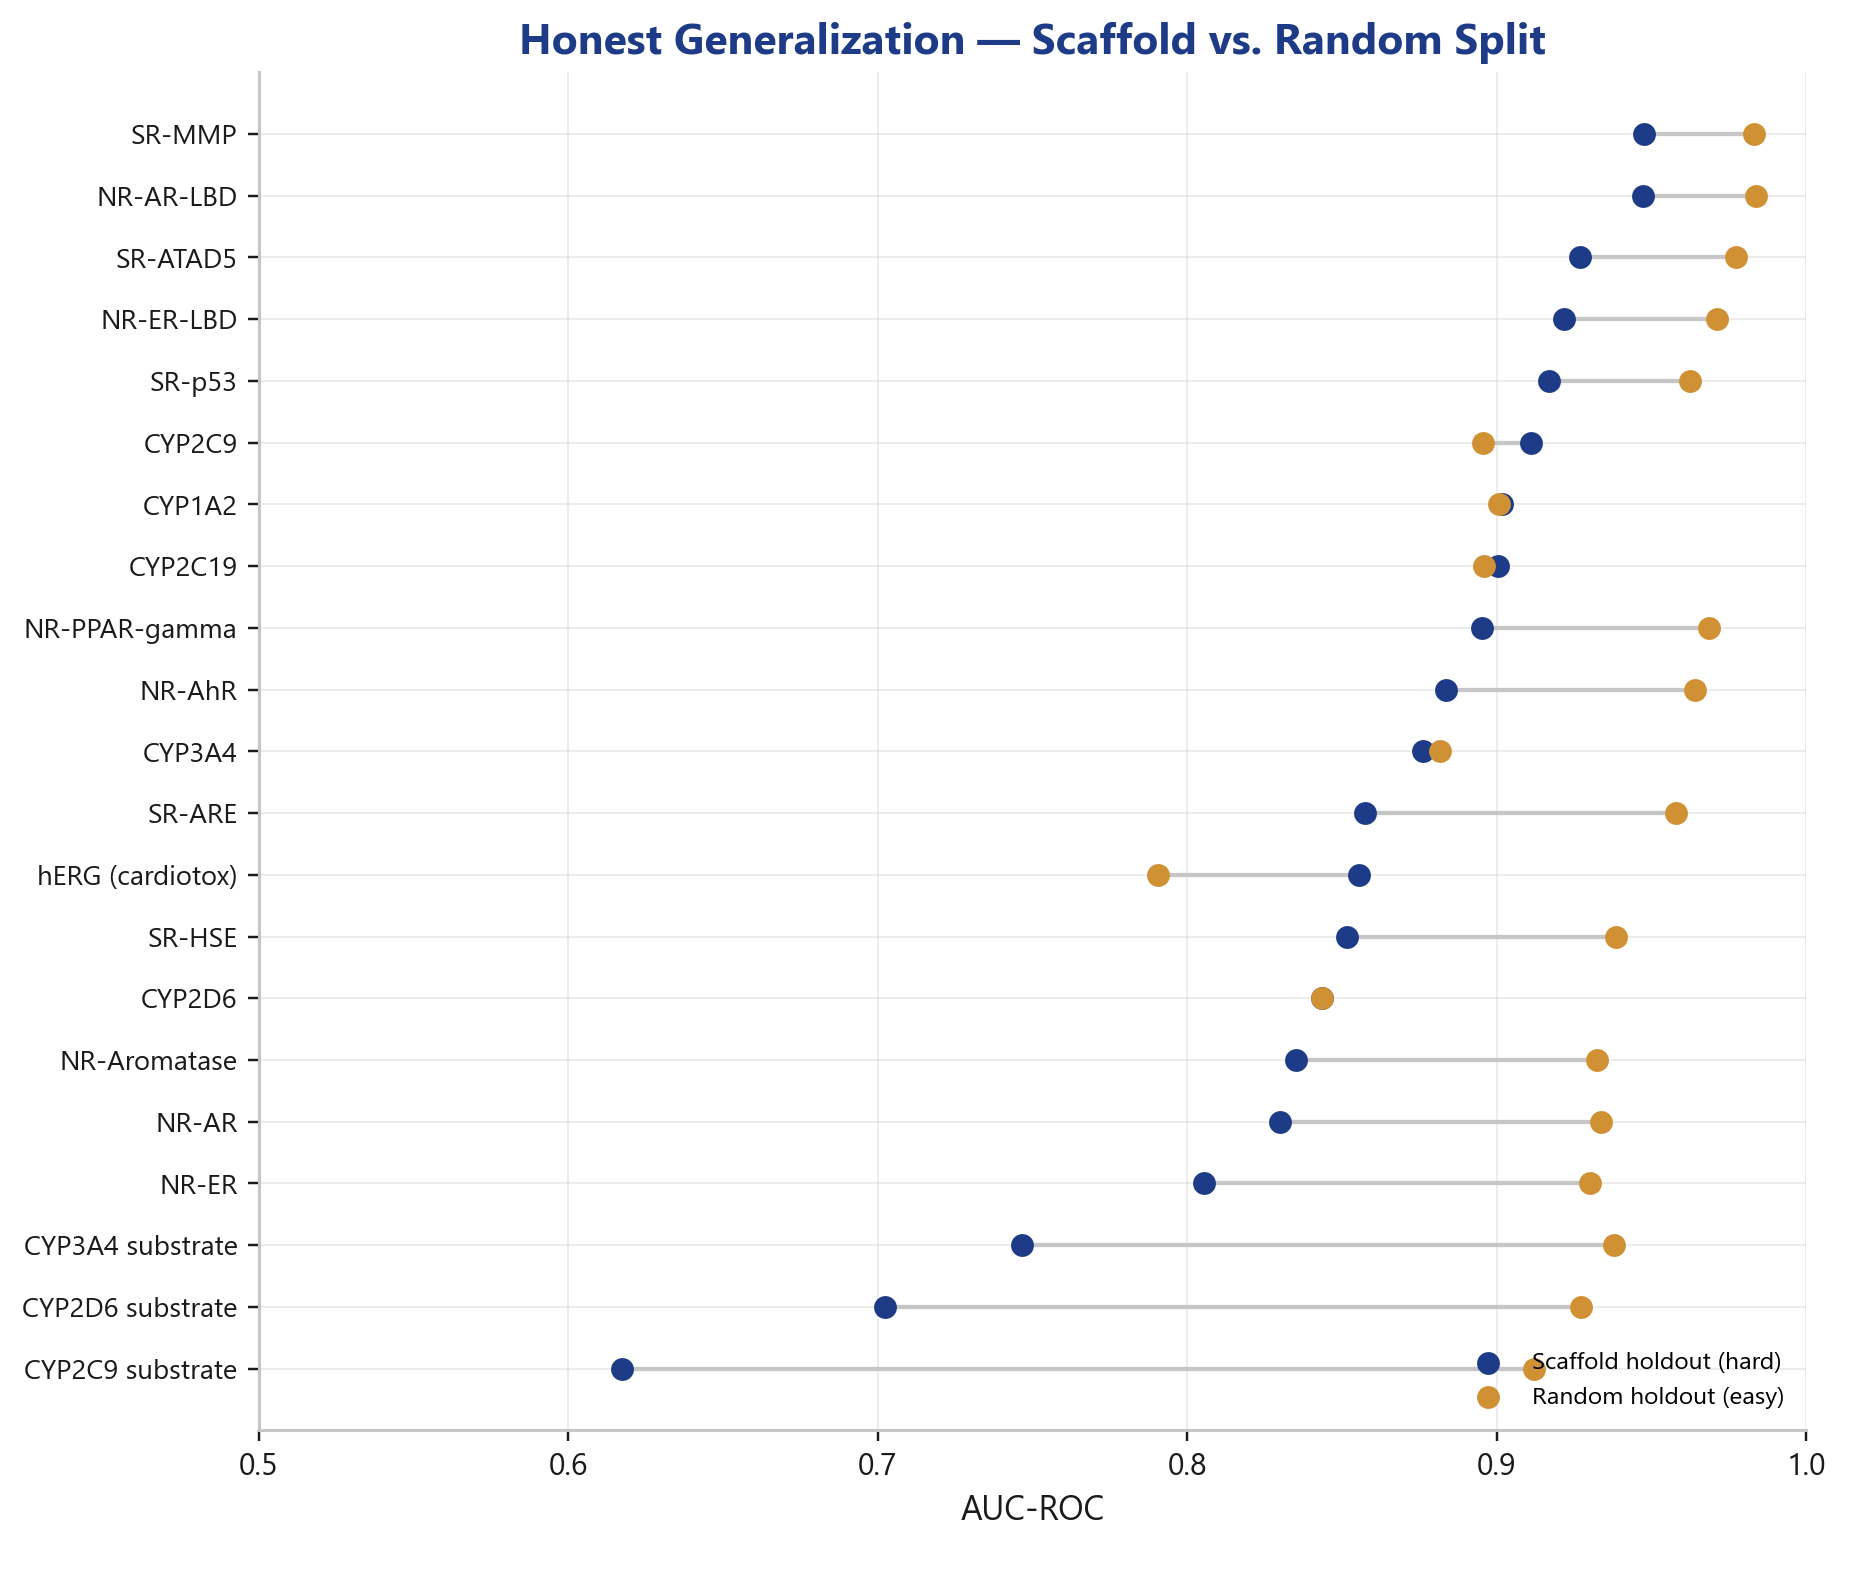
Wie schon bei der Löslichkeitsvorhersage berichten wir die harte Zahl. Beim Random-Split landen strukturell ähnliche Moleküle in Training und Test; das Modell sieht im Test alte Bekannte, und die Werte sehen besser aus, als sie in der echten Forschung halten. Beim Scaffold-Holdout werden ganze Molekülgerüste zurückgehalten; das Modell muss auf neue Strukturklassen generalisieren.
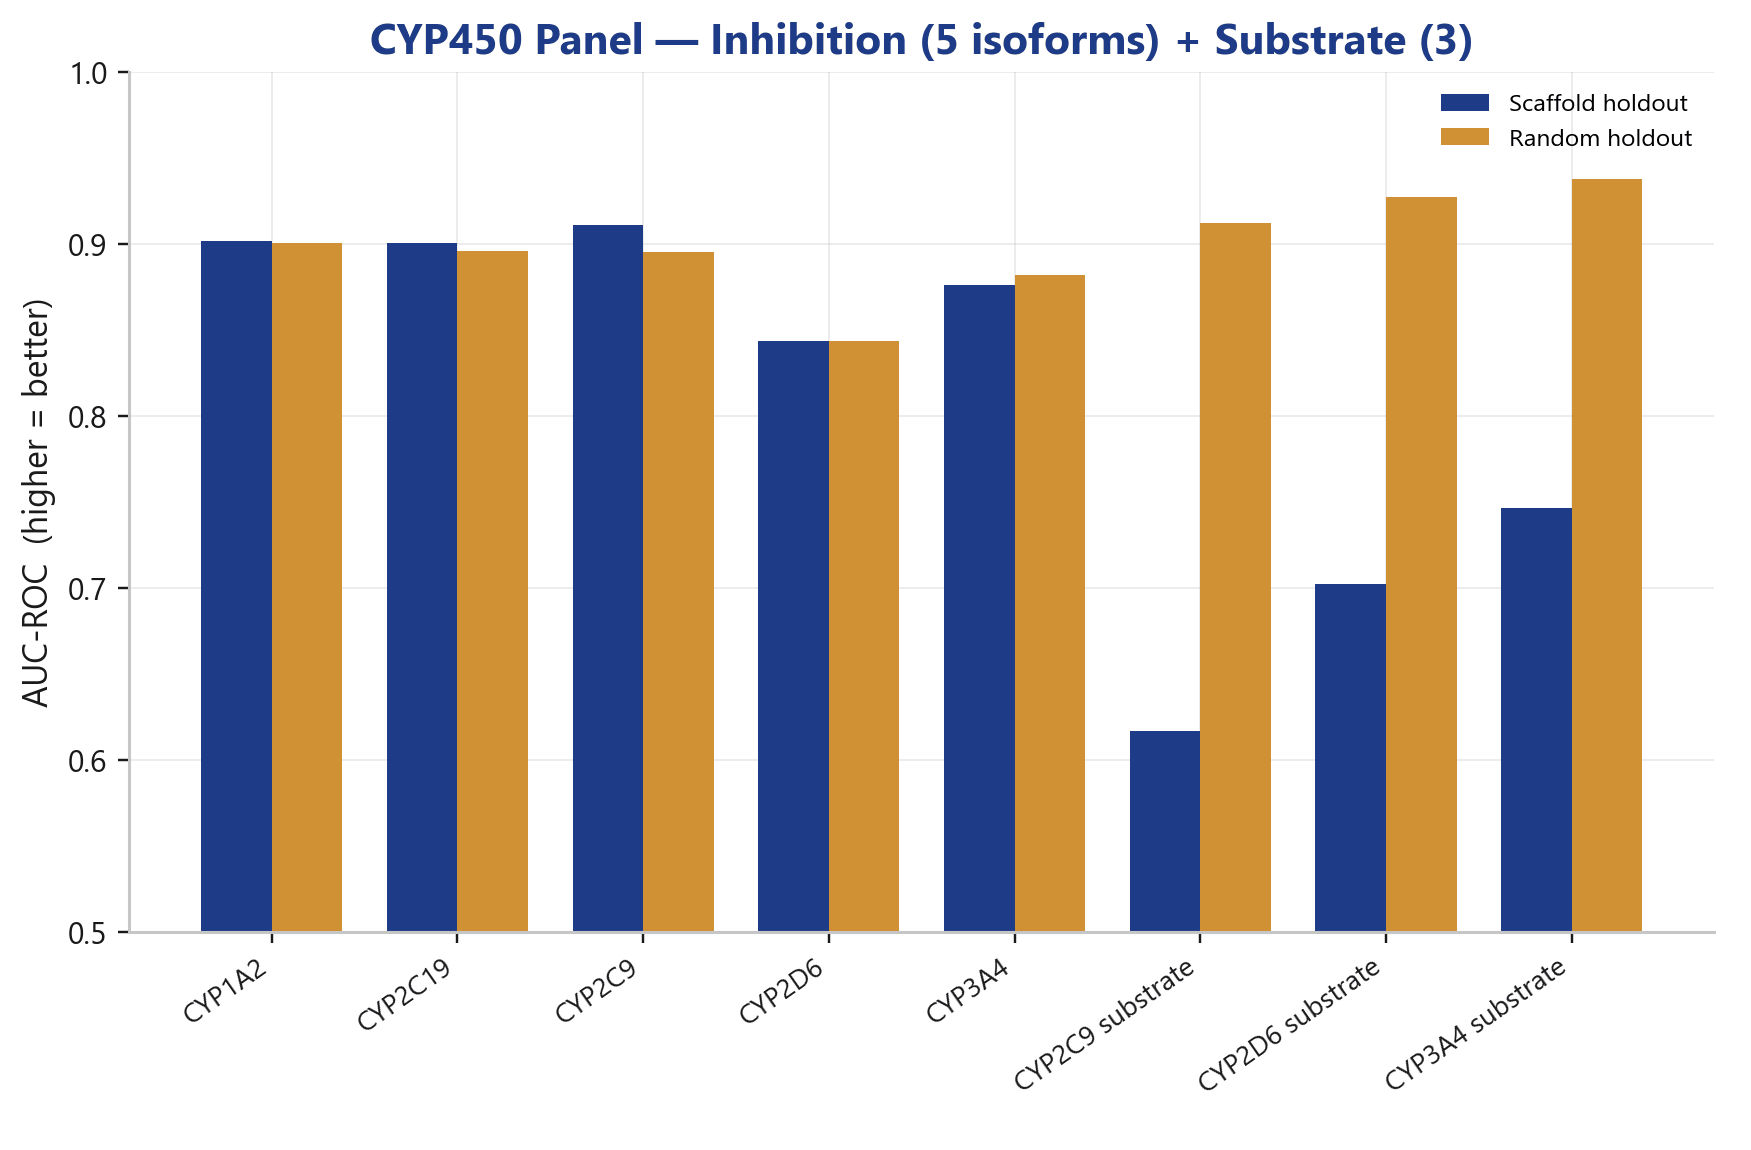
Der Abstand zwischen beiden ist real und für jeden Endpunkt sichtbar: Bei den meisten liegt der Random-Wert über dem Scaffold-Wert, bei einigen (z. B. CYP2D6-Substrat, CYP3A4-Substrat) ist die Lücke erheblich. Wir berichten den Scaffold-Wert als Kennzahl: das ehrliche Maß dafür, wie das Modell auf neue Chemie reagiert. Ein Anbieter, der nur Random-Split-Zahlen zeigt, misst eine leichtere Aufgabe.
Der eigentliche Lackmustest: ein echter Vergleich
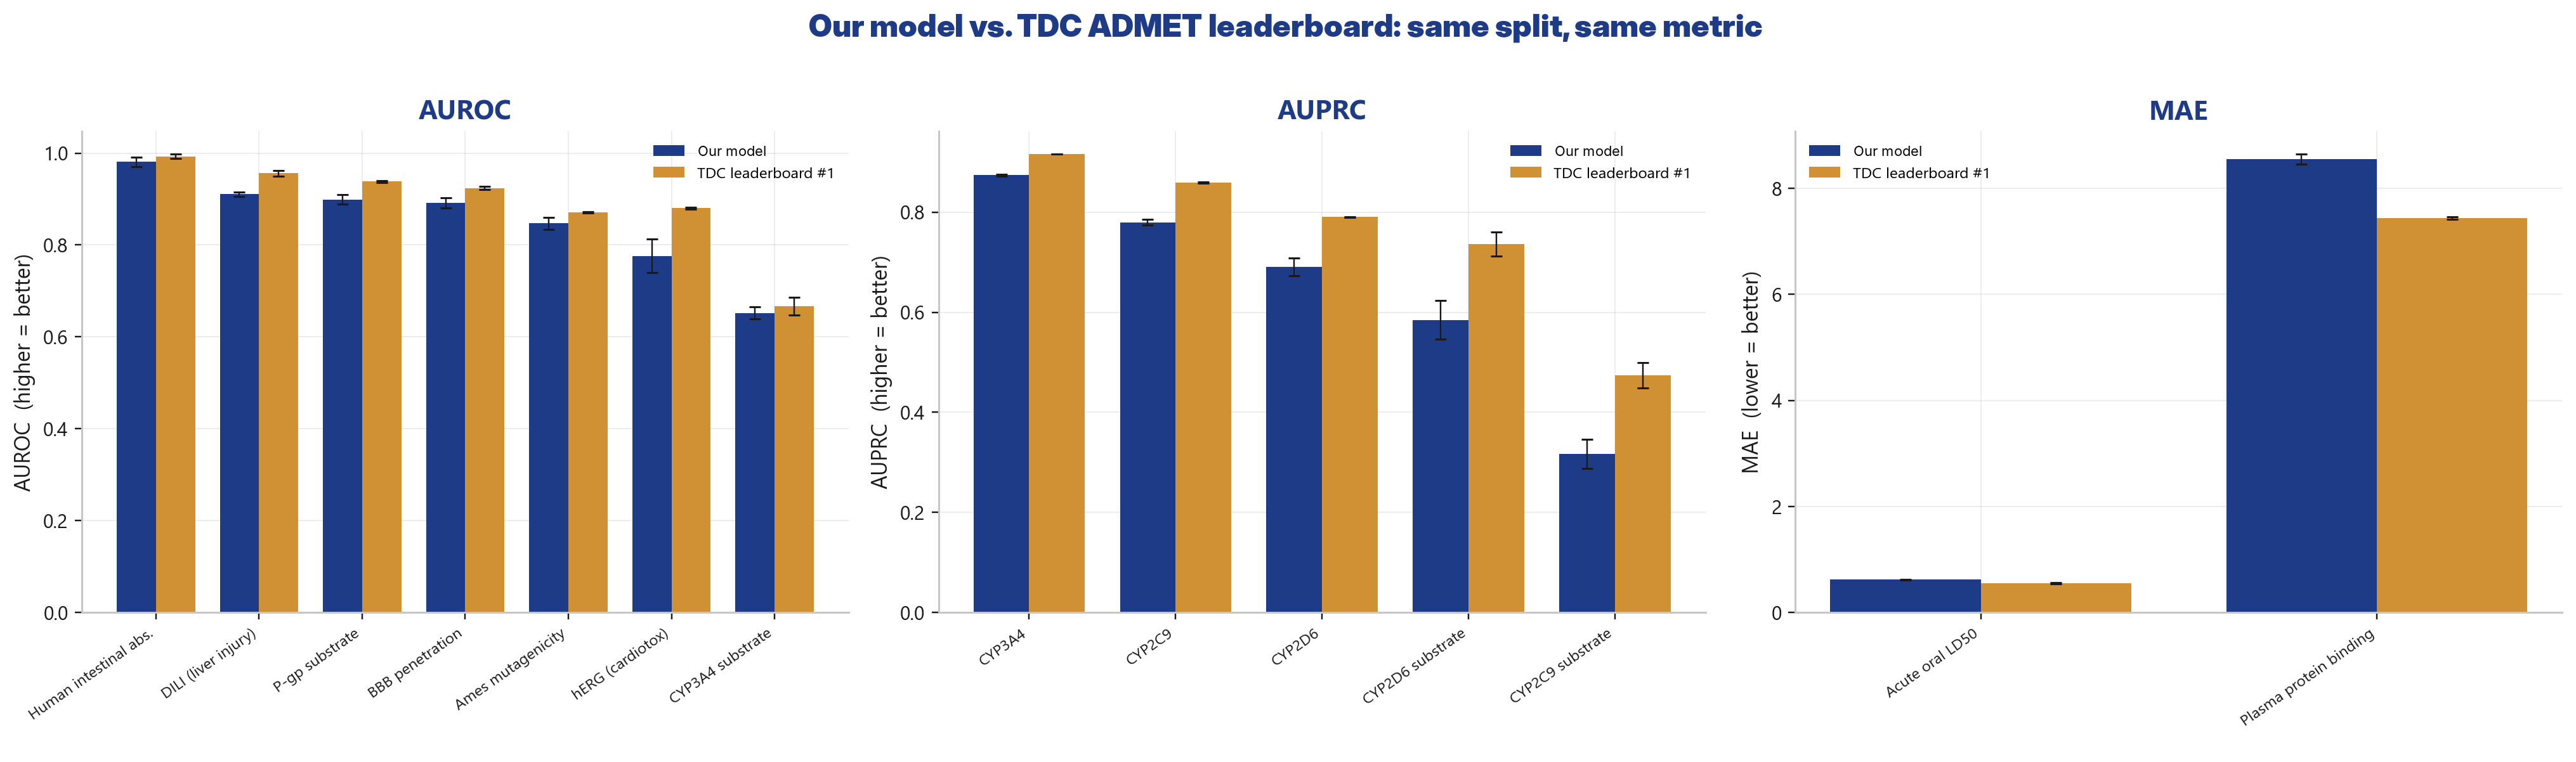
Die meisten "SOTA"-Behauptungen in der Tox-Vorhersage sind nicht überprüfbar, weil sie auf unterschiedlichen Datensätzen und Splits laufen. Wir wollten einen Vergleich, der einem Reviewer standhält, und haben deshalb das Gegenteil getan: einen echten direkten Same-Split-Same-Metric-Vergleich gegen das TDC-ADMET-Benchmark-Leaderboard.
Die Methodik ist bewusst streng:
- Gleicher Split. Für die 14 ADMET-Datensätze, die auf einen Endpunkt unserer Vorhersage abbilden, nutzen wir TDCs offiziellen Train/Test-Split.
- Kein Leakage. Die Toxizitätsvorhersage wird neu und ausschließlich auf dem offiziellen Trainings-Split trainiert (5 Seeds), nicht das ausgelieferte Modell, dessen Trainingsdaten sich mit dem TDC-Testset überschneiden würden.
- Gleiche Metrik. Bewertet von TDCs eigenem Evaluator, der je Datensatz die offizielle Metrik anwendet (AUROC, AUPRC oder MAE).
- Zitierbare Referenz. Vergleichsbalken ist der aktuelle #1-Leaderboard-Eintrag je Datensatz.
Und jetzt das Ergebnis, ungeschönt.
Was der Vergleich zeigt
Auf den AUROC-Endpunkten, den klassischen Tox/ADMET-Klassifikationen, ist die Toxizitätsvorhersage konkurrenzfähig, aber noch nicht führend. Im Schnitt liegt sie rund vier AUROC-Punkte unter dem jeweils besten Modell. Bei einigen Endpunkten ist der Abstand klein:
- Darmabsorption (HIA): unser Modell 0,981, TDC #1 0,993 (MiniMol)
- Leberschädigung (DILI): unser Modell 0,911, TDC #1 0,956 (MiniMol)
- Ames-Mutagenität: unser Modell 0,847, TDC #1 0,871 (ZairaChem)
- CYP3A4-Substrat: unser Modell 0,652, TDC #1 0,667 (CFA)
Bei anderen ist er größer: hERG (0,776 vs. 0,880, MapLight+GNN) ist der deutlichste Rückstand und ein klarer Verbesserungspunkt. Auf den AUPRC-Substrat-Endpunkten (CYP2C9-/CYP2D6-Substrat) und bei der Plasmaproteinbindung (PPBR, MAE) liegt die Toxizitätsvorhersage spürbar zurück.
Der entscheidende Kontext: Die Leaderboard-Sieger sind in der Regel Modelle, die auf genau diesen einen Datensatz optimiert wurden; verschiedene Methoden gewinnen verschiedene Datensätze (MiniMol, MapLight+GNN, ZairaChem, ContextPred). Unsere Toxizitätsvorhersage erreicht ihre Werte mit einem einheitlichen Verfahren über alle 42 Endpunkte, im Einsatz für echte Laborfragen. Das ist eine andere Abwägung: nicht der Spitzenwert auf einem Datensatz, sondern verlässliche Breite in einem einsatzfähigen System.
Die Panels im Detail
Das Tox21-Panel ist als geteilter Multi-Task-Cluster trainiert und liegt durchgängig im soliden Bereich: mehrere Ziele (SR-MMP 0,948, NR-AR-LBD 0,947, SR-p53 0,917) über 0,9 auf dem Scaffold-Split.
Das CYP450-Panel zeigt das erwartbare Muster: Die fünf Inhibitions-Isoformen sind stark (CYP2C9 0,911, CYP1A2 0,902, CYP2C19 0,901), während die Substrat-Vorhersage, eine generell schwierige Aufgabe mit wenig Daten, schwächer ausfällt. Das ist konsistent mit dem gesamten Feld und kein die Toxizitätsvorhersage-spezifisches Problem.
Ehrlich eingeordnet, und wohin es geht
Wir hätten aus diesen Daten eine "SOTA"-Schlagzeile machen können, indem wir Random-Split-Zahlen zeigen oder uns die günstigsten Endpunkte herauspicken. Das tun wir bewusst nicht. Der Stand ist:
- Stark und einsatzbereit: breite ADMET-/Tox-Abdeckung, solide Scaffold-Werte auf den meisten Klassifikations-Endpunkten, in einer Suite.
- Konkurrenzfähig: auf den AUROC-Endpunkten innerhalb weniger Punkte der besten spezialisierten Einzelmodelle, und das mit einem generalistischen Modell.
- Noch nicht führend: die Substrat-Endpunkte, hERG und PPBR sind offene Verbesserungsziele für den nächsten Trainingszyklus. Wir benennen sie, statt sie zu verschweigen.
Diese Offenheit ist Absicht. Eine überprüfbare, ehrliche Zahl ist in einem regulierten Umfeld mehr wert als eine beeindruckende, die beim ersten Reviewer zerfällt. Die vollständige Endpunkt-Scorecard mit Scaffold- und Random-Werten steht unter covasyn.com/benchmark.
Selbst nachvollziehen
Ein Sicherheitsprofil für Ihre eigene Struktur bekommen Sie als Bericht: Tox21, CYP450, hERG, DILI und mehr, jeweils mit der Holdout-Metrik dahinter. → Beispielauswertungen ansehen
Häufige Fragen
Lässt sich Toxizität vorhersagen?
Für viele Endpunkte ja, mit guter Genauigkeit. Die Toxizitätsvorhersage erreicht auf dem harten Scaffold-Holdout einen mittleren Klassifikations-AUC von 0,860 über 42 ADMET-/Tox-Endpunkte; einige (Darmabsorption, DILI, mehrere Tox21-Ziele) liegen über 0,9. Andere, etwa Enzym-Substrat-Vorhersagen, bleiben für das gesamte Feld schwierig.
Was ist ein guter AUROC für die Toxizitätsvorhersage?
Als Orientierung gilt ein AUROC ab rund 0,85 als stark, ab 0,9 als sehr gut, sofern er auf einem ehrlichen Split (Scaffold-Holdout) und nicht auf einem optimistischen Random-Split gemessen wurde.
Wie schneidet die Toxizitätsvorhersage gegen das TDC-Leaderboard ab?
In einem echten Same-Split-Same-Metric-Vergleich liegt die Toxizitätsvorhersage auf den AUROC-Endpunkten im Schnitt wenige Punkte unter den jeweils besten, auf einen Datensatz spezialisierten Modellen, erreicht das aber mit einer einzigen Pipeline über alle 42 Endpunkte. Substrat-Endpunkte und PPBR sind offene Verbesserungsziele.
Was ist der Unterschied zwischen Scaffold- und Random-Split bei der Tox-Vorhersage?
Beim Random-Split ähneln Testmoleküle dem Training, was die Genauigkeit überschätzt. Beim Scaffold-Split werden ganze Molekülgerüste zurückgehalten; das misst echte Generalisierung auf neue Chemie. Die Toxizitätsvorhersage berichtet den Scaffold-Wert.
Deckt die Toxizitätsvorhersage ICH-M7-relevante Endpunkte ab?
Ja, Mutagenität (Ames) ist Teil der Suite und ein zentraler Baustein für die Verunreinigungsbewertung. Ein eigener Praxisartikel dazu folgt.
Methodik & Daten
Toxizitätsvorhersage von CovaSketch, 42 Endpunkte. Maßgeblicher Split: Scaffold-Holdout (neue Molekülgerüste), Random-Holdout als Kontext. TDC-Direktvergleich: offizielle Splits der TDC ADMET Benchmark Group, 5 Seeds, bewertet via group.evaluate; Referenz ist der jeweilige #1-Leaderboard-Eintrag. Quelle: TDC ADMET Benchmark Group (tdcommons.ai/benchmark/admet_group, abgerufen am 23.05.2026); Huang et al., Nat Chem Biol 18, 1033 (2022). Ausgeschlossen: algae_ec50 (degeneriert), clintox (untrainiert). Datenstand: 23.05.2026.